Prøveeksamen
| 9. november 2026 |
| 4 timer |
| Lukket digital eksamen (med safe exam browser). |
| Tillatte hjelpemiddel: bøker frå litteraturlista og opp til 6 tosidige A4 ark med eigne notat. |
Oppgavetekster, løsningsforslag og sensorveiledning finner du på denne siden.
Fordi eksamen var en lukket digital eksamen uten tilgang til å kjøre koden eller bruke internett, bes sensor ikke gi poengtrekk for forhold som enkelt ville blitt oppdaget og raskt rettet ved kjøring av koden. Dette inkluderer blant annet:
- manglende
import-setninger, - manglende kodeord (som f. eks. manglende
defforan funksjonsdefinisjoner), - feil navn på funksjoner og metoder i standardbiblioteket, i egen kode eller i eksterne moduler (såfremt det fremgår noenlunde av funksjonsnavnet hva kandidaten egentlig mener),
- feil navn på variabler (f. eks. kalle den samme variabelen både
totalogsumi ulike deler av koden), - enkle syntaks-feil (f. eks. manglende kolon etter
if-setninger), - og så videre.
Logiske feil skal det likevel (som hovedregel) bli trukket litt for; selv om man kunne ha oppdaget at noe var feil ved kjøring av koden. Dette inkluderer blant annet:
-
presedensfeil,
-
forveksling av indekser og elementer,
-
off-by-one -feil,
-
feil i algoritmer,
-
og så videre.
1 Automatisk rettet
Deloppgaver a-e: oppgaver, fasit
Oppgave 1(f) og 1(g) ba kandidatene om å skrive korte kodesnutter. Noen tester var oppgitt, og man kunne teste/kjøre koden sin underveis på eksamen i disse oppgavene. Alle testene må passeres for å få poeng, men kandidatene får vite umiddelbart om koden man skrev passerer de oppgitte testene eller ikke.
Denne oppgaven har samme format som i første kodestafett.
Les en streng fra kommandolinjen med input(). Strengen representerer en liste med heltall formatert som JSON. Skriv ut produktet av alle tallene.
| Test case # | Input | Forventet output |
|---|---|---|
| 1 | [2, 3, 4] | 24 |
| 2 | [5, 5] | 25 |
| 3 | [1, 2, 3, 4, 5] | 120 |
| Test case # | Input | Forventet output |
|---|---|---|
| 1 | [2, 3, 4] | 24 |
| 2 | [5, 5] | 25 |
| 3 | [1, 2, 3, 4, 5] | 120 |
| 4 | [1, 1, 3, 1, 1, 1, 1, 1, 4] | 12 |
import json

tall = json.loads(input())

produkt = 1
for t in tall:
    produkt *= t

print(produkt)
Skriv en funksjon expand med en parameter pairs. Anta at pairs er en liste av lister som representerer en tabell av bokstaver og tilsvarende antall. Et eksempel for pairs er:
[['a',3],['f',1],['c',2]]
La funksjonen returnere en streng der hver bokstav gjentas så mange ganger som antallet sier, i samme rekkefølge som i listen pairs. Hvis pairs er tom, skal funksjonen returnere None.
| Test case # | Input | Forventet output |
|---|---|---|
| 1 | expand([[‘a’,3],[‘b’,1]]) | aaab |
| 2 | expand([]) | None |
| 3 | expand([[‘x’, 2], [‘y’, 2], [‘x’, 1]]) | xxyyx |
| Test case # | Input | Forventet output |
|---|---|---|
| 1 | expand([[‘a’,3],[‘b’,1]]) | aaab |
| 2 | expand([]) | None |
| 3 | expand([[‘x’, 2], [‘y’, 2], [‘x’, 1]]) | xxyyx |
| 4 | expand([[‘z’, 1]]) | z |
| 5 | expand([[‘a’, 3],[‘a’,2]]) | aaaaa |
def expand(pairs):
    result = ''
    for letter, count in pairs:
        result += letter * count
    return result
2 Forklaring
Et gammelt jungelord sier at programmering består av 10% koding og 90% å forstå hvorfor det ikke virker. I denne oppgaven fokuserer vi på de siste 90%.
Du har nettopp slengt sammen et Asteroids-spill med god hjelp av kunstig intelligens. Spillet ser ut til å virke som det skal helt til en kule treffer en stein. Da krasjer spillet med denne feilmeldingen:
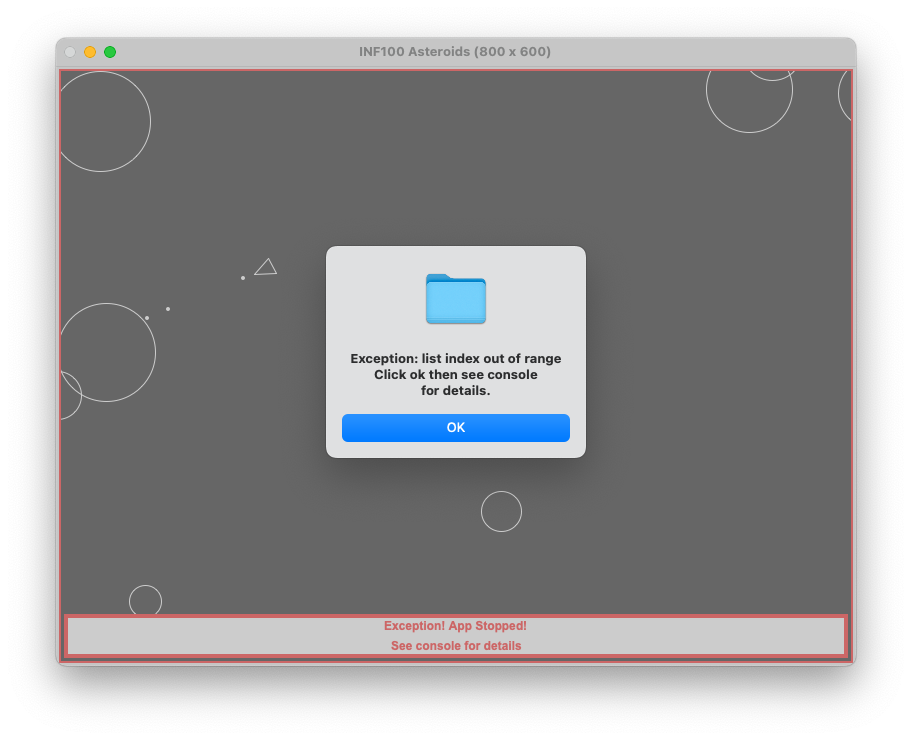
  Traceback (most recent call last):
    File "/path/to/asteroids.py", line 55, in timer_fired
      check_bullet_hits(app)
    File "/path/to/asteroids.py", line 132, in check_bullet_hits
      x, y, radius, _, _ = app.stones[j]
                          ~~~~~~~~~~^^^
  IndexError: list index out of range
Oppførselen vi beskriver over skjer de fleste ganger, men ikke alltid: av og til klarer skuddet faktisk å skyte bort steinen.
Kildekoden for spillet ligger i vedlagt pdf.
Forklar:
- Hva betyr feilmeldingen? Forklar all informasjonen feilmeldingen gir oss.
- Hva er grunnen til at feilen oppstår? Hvorfor krasjer ikke spillet hver eneste gang en kule treffer en stein?
- Hvilke mulige løsninger ser du for deg? Du skal ikke skrive kode, men forklare med ord og relevante fagbegreper hva som er mulige løsninger og hvordan de vil løse problemet.
Hva betyr feilmeldingen? Forklar all informasjonen feilmeldingen gir oss.
- Feilmeldingen forteller at indeksen
jer for stor eller for liten («out of range»), slik at det ikke finnes noe element i denne posisjonen i app.stones. - Vi ser også at app.stones er en liste («list index out of range»).
- Krasjen skjer på linje 132, som er en del av funksjonen check_bullet_hits i filen asteroids.py.
- Funksjonen check_bullet_hits ble kalt på linje 55, som er en del av funksjonen timer_fired i filen asteroids.py.
Hva er grunnen til at feilen oppstår?
Listen app.stones blir kortere underveis i for-løkken hvor j er iteranden (.pop fjerner jo et element fra listen). Hvilke verdier løkken skal iterere gjennom ble derimot bestemt før løkken egentlig startet, nemlig da uttrykket range(len(app.stones)) ble evaluert. Når løkken kommer til siste iterasjon viser iteranden j altså til siste indeks i app.stones slik den var da løkken startet. Men fordi den har krympet underveis, er indeksen for stor, og programmet krasjer.
(forøvrig har koden akkurat samme bug når det gjelder app.bullets og løkken med iteranden i)
Hvorfor krasjer ikke spillet hver eneste gang en kule treffer en stein?
Programmet vil ikke krasje her dersom steinen som treffes er den siste steinen i listen.
Hvilke mulige løsninger ser du for deg?
Jeg ser for meg flere mulige løsninger:
-
Returner fra funksjonen med en gang vi finner en stein truffet av en kule. Funksjonen vil riktignok kun fjerne én stein og én kule, men siden funksjonen kalles veldig ofte er det ikke så lenge til neste gang den kalles at det vil være noe problem i praksis. I teorien vil vi kunne få situasjoner der en kule flyr gjennom en stein uten å ødelegge den, så den er ikke helt idéell.
-
Kall en hjelpefunksjon som fjerner første funnede treff i en while-løkke. Dette er i grunnen den samme løsningen som nummer (1), men vi lar funksjonen returnere True hvis den fant en treff og fjernet stein/kule og False hvis ikke. Så bruker vi den som en hjelpefunksjon, og kaller på den i en while-løkke helt til den returnerer False.
-
Bruk break for å avbryte løkken når en stein er truffet. Det er en rimelig antakelse at én kule kun treffer én stein – så når vi har funnet en truffet stein er det strengt tatt ikke behov for flere iterasjoner av den indre løkken som går gjennom steinene, og vi kan bruke break for å avslutte løkken tidlig. Denne løsningen gjør forsåvidt at problemet med krasj på linje 132 forsvinner, men løser ikke det tilsvarende problemet som er gjeldende for
app.bulletsogii den ytterste løkken. -
Legg steiner og kuler som skal fjernes i egen liste først. Vi bruker først en løkke lignende den vi allerede har for å identifisere hva som skal fjernes av steiner og kuler, men i stedet for å fjerne («poppe»), legger vi istedet det som skal fjernes i egne lister over «markerte» steiner/kuler. Deretter har vi ekstra løkker etterpå for å fjerne («remove», ikke «pop») de markerte steinene/kulene. I denne løsningen er det altså selve steinen/kulen som skal fjernes man legger til i hjelpelisten, ikke indeksen. Det er mulig å legge til indeksen i hjelpelisten, men da må man bruke idéer fra løsningsforslag 5 eller 6 i tillegg for å ikke introdusere nye bugs.
-
Opprett nye lister over kuler og steiner i stedet for å mutere eksisterende liste. Vi kan først opprette en ny liste som inneholder alle steiner som ikke er truffet av noen kule, og tilsvarende en ny liste av alle kuler som ikke er truffet av noen stein, og så la app.bullets og app.stones vise til disse nye listene. Det er i så fall aktuelt med hjelpefunksjoner
stone_is_hit(single_stone, list_of_bullets)ogbullet_hit_something(single_bullet, list_of_stones)for å avgjøre hvilke kuler og steiner vi skal ta vare på. Alternativt kan vi også gjøre som i løsningsforslag (4) først, og deretter lage de nye listene over kuler og steiner med de elementene som ikke er markert. PS: Det kan kanskje fremstå som unødvendig kostbart å opprette en ny liste, men dette er faktisk mer effektivt enn løsninger som muterer en liste flere ganger. -
Gå gjennom indeksene baklengs. I stedet for at løkkene begynner med den første indeksen og beveger seg oppover, kan vi i stedet begynne med den høyeste indeksen og gå nedover. Da får vi ikke problemer når listen blir kortere, siden elementene som får nye indekser etter popping er de elementene som allerede er ferdig sjekket. For å gjøre dette kan vi bruke en range med negative steg, f. eks.
range(len(app.stones) - 1, -1, -1)i stedet forrange(len(app.stones))ogrange(len(app.bullets) - 1, -1, -1)i stedet forrange(len(app.stones)). En annen variant av dette er å bruke negative indekser når vi henter ut elementer, dvs brukeapp.stones[-j-1]i stedet forapp.stones[j]ogapp.stones.pop(-j-1)i stedet forapp.stones.pop(j)(og tilsvarende for i og app.bullets). -
Bruk while-løkker. Ved å bruke while-løkker i stedet for for-løkker har vi større kontroll på hvordan indeksen endrer seg fra iterasjon til iterasjon. Betingelsen i while-løkker (typisk
i < len(app.bullets)ogj < len(app.stones)) sjekkes dessuten på nytt i hver iterasjon, slik at hvis lengden på listene minker underveis, vil løkken også gjøre færre iterasjoner. Det kan imidlertid oppstå feil ved at noen sjekker «hoppes over» om vi ikke er forsiktig med hvordan indeksene økes: når vi fjerner noe fra en liste, vil resten av listen flytte seg nedover, så å øke indeksen vil hoppe over elementet som ble flyttet ned. Vi kan ta høyde for dette ved å kun inkrementere indeksene dersom vi ikke fjernet. Uansett om vi ikke tar høyde for dette, vil feilen være av begrenset betydning i praksis, siden funksjonen kalles på nytt mange ganger i sekundet.
Hva betyr feilmeldingen? (3 poeng)
Listen er for liten for indeksen som benyttes (1 poeng). Identifiserer at krasjen skjer på linje 132, eller identifiserer at feilen skjer som en del av et funksjonskall til check_bullet_hits (1 poeng). Identifiserer at funksjonskallet til check_bullet_hits ble gjort på linje 55, eller at det ble gjort som en del av timer_fired (1 poeng).
Hva er grunnen til at feilen oppstår? Hvorfor krasjer ikke spillet hver eneste gang en kule treffer en stein? (2 poeng)
Listen blir kortere underveis i løkken (1 poeng). Programmet vil ikke krasje her dersom steinen som treffes er den siste steinen i listen (1 poeng).
Hvilke mulige løsninger ser du for deg? (4 + 1 poeng)
Et løsningsforslag som ikke fungerer gir 0-1 poeng basert på sensors skjønn. Et løsningsforslag som vil fungere greit i praksis, men som i teorien har noen svakheter (f. eks. å returnere fra funksjonen etter første treff) gir 2 poeng hvis det presenteres uten å påpeke svakhetene, men gir 3 poeng hvis svakhetene drøftes. Et fullverdig løsningsidé gir 4 poeng. Løsningen trenger ikke beskrives i pinlig detalj, så lenge idéen er kommunisert (for eksempel er det tilstrekkelig å si at vi kan gå gjennom listene baklengs i stedet for fremlengs uten å gå i detalj om hvordan dette gjøres.)
I tillegg
Løsningsforslaget tar hensyn til funksjonen som helhet og retter også opp identisk bug/den delen av bug’en som er knyttet til app.bullets og ytterste løkke. Poenget deles ut så lenge kandidaten viser forståelse for at samme bug gjelder for app.bullets og ytre løkke, eller om løsningsforslaget implisitt tar slike hensyn. (1 poeng).
Helhetsvurdering (2 poeng). Poengene i denne kategorien deles ut helhetlig, ikke punkt for punkt. Sensor kan bruke dennne kategorien for å trekke opp eller ned kandidater som demonstrerer større eller mindre forståelse enn hva rubrikken forøvrig tilsier. Sensor ser etter:
Det er lett å forstå hva kandidaten mener. God/relevant bruk av faguuttrykk. Demonstrerer forståelse av koden og mulighetene for endring.
Et revolusjonært komité har tatt makten. De ga i oppdrag å utvikle følgende program for å administrere lederskapet:
def foo(lst):
  last = lst[-1]
  for i in range(len(lst) - 1, 0, -1):
    lst[i] = lst[i - 1]
  lst[0] = last

names = ["Bashar", "Robert", "Fidel", "Vladimir", "Kim"]
foo(names)
print(names)
Hva gjør funksjonen foo()? Hva skriver programmet ut? Gi funksjonen foo() et bedre navn, slik at folk enkelt kan forstå hva funksjonen gjør uten å vite hvordan den er implementert.
- Funksjonen flytter det siste elementet i listen til første posisjon og forskyver alle de øvrige elementene én plass mot høyre i listen.
- Programmet skriver ut [“Kim”, “Bashar”, “Robert”, “Fidel”, “Vladimir”]
- Et bedre navn for denne funksjonen kan være rotate. Navnet må uttrykke betydningen av å rotere eller forskyve.
- (2 poeng) Hva gjør funksjonen foo()?
- (1 poeng) Hva skriver programmet ut?
- (2 poeng) Gi funksjonen foo() et bedre navn, slik at folk enkelt kan forstå hva funksjonen gjør uten å vite hvordan den er implementert.
3 Kodeskriving

Skriv ein kodesnutt slik at minnet får den tilstanden som er vist ovanfor.
Klikk på «se steg» -knappen for å verifisere at denne koden gir riktig bilde av minnet.
a = [["hello", "world"], ["hello", "world"]]
b = a
- 1 poeng hvis a og b begge er lik
[["hello", "world"], ["hello", "world"]] - 1 poeng hvis
a[0]oga[1]ikke er aliaser,a[0]er alias medb[0]oga[1]er alias medb[1] - 1 poeng hvis
aogber aliaser`
Sensor har anledning til å gjøre en skjønnsmessig justering i tilfeller der hen mener disse testene ikke gir et representativt bilde av hva studenten demonstrerer.
Sensor skal ikke kreve syntaktisk korrekthet – men hvis besvarelsen er syntaktisk korrekt eller er rettet opp til å bli det kan poengsummen som beskrevet over regnes ut med følgende kode:
points = sum([
    a == b == [["hello", "world"], ["hello", "world"]],
    a[0] is not a[1] and a[0] is b[0] and a[1] is b[1],
    a is b,
])
# PS: i kontekst av matematisk aritmetikk regnes True som 1 og False som 0.

Skriv ein kodesnutt slik at minnet får den tilstanden som er vist ovanfor. Hint: Du må mutere minst ei av listene etter at ho blir oppretta første gong.
Et knippe løsninger som alle er riktige. Klikk på «se steg» -knappen for å verifisere at koden gir riktig bilde av minnet.
a = ['hello']
b = ['world', a]
a.append(b)
a = ['hello']
b = ['world', a]
a += [b]
a = ['hello']
b = ['world']
a.extend([b])
b.extend([a])
a = ['hello', 'anything']
b = ['world', a]
a[1] = b
- 3 poeng gis for en korrekt løsning. Da evaluerer dette uttrykket til True:
(
  a[0] == 'hello' and b[0] == 'world' and
  a[1] is b and b[1] is a and
  len(a) == len(b) == 2
)
Det skal ikke gis trekk dersom
.appender navngitt feil eller dersom kandidaten har blandet.appendmed.extendeller.addeller andre tilsynelatende muterende metoder.
- 2 poeng gis for løsninger som har riktig idé, men hvor muterende operasjoner ikke er gyldige, for eksempel
a = ['hello']
b = ['world', a]
a[1] = b
- 2 poeng gis for løsninger som har riktig idé, men hvor det benyttes en ikke-destruktiv operasjon for å endre på listen i stedet for en muterende opersajon, for eksempel
a = ['hello']
b = ['world', a]
a = a + [b]
- 1 poeng gis for løsninger hvor det er mer tydelig at man lager en ny liste i stedet for å mutere, for eksempel
a = ['hello']
b = ['world', a]
a = ['hello', b]
- 1 poeng gis for en løsning som krasjer fordi variabler ikke er definert enda på tidspunktet de referes til, for eksempel:
a = ['hello', b]
b = ['world', a]
- 1 poeng gis for løsninger som mangler én av pekerne til den andre listen, for eksempel
a = ['hello']
b = ['world', a]
Løsninger som er lengre unna en riktig løsning enn eksemplene over gir 0 poeng..
Anta at du har en aktivitetslogg for et hotell. Aktivitetsloggen er en semikolon-separert csv-fil der hver rad representerer én hendelse. Kolonnene i csv-filen er
- tidspunkt (formattert som yyyy-MM-dd HH:mm)
- hendelsestype (enten «innsjekk» eller «utsjekk»)
- romnummer
- navn på gjesten Eksempel på de første par linjene i filen:
  tidspunkt;hendelsestype;romnummer;navn på gjest
  2024-01-01 16:34;innsjekk;201;Donald
  2024-01-01 17:15;innsjekk;302;Dolly
  2024-01-02 09:14;utsjekk;201;Donald
  2024-01-02 10:45;innsjekk;201;Magica fra Tryll
  2024-01-02 10:59;utsjekk;302;Dolly
Anta at hendelsene allerede ligger i sortert rekkefølge basert på tidspunkt, og at ingen var sjekket inn på hotellet på tidspunktet loggen begynner. Du kan også anta at loggfilen er konsistent (utsjekk har alltid samme navn på personen som forrige gang det var innsjekk på samme romnummer; og det er alltid annenhver innsjekk og utsjekk om vi kun ser på ett rom av gangen).
Det er tre deloppgaver:
-
(5 poeng) Skriv en funksjon load_logfile(path) hvor path er en parameter for filnavnet til loggfilen. Funksjonen skal returnere innholdet i filen på et format egnet for videre prosessering i Python. Du kan velge selv om du vil returnere en 2D-liste eller en liste av oppslagsverk.
-
(10 poeng) Skriv en funksjon current_guest_count(table) hvor table er en liste på det formatet du valgte i forrige deloppgave. Funksjonen skal returnere antallet gjester som er sjekket inn på hotellet når loggfilen tar slutt.
Eksempel: dersom filen kun bestod av linjene i eksempelet over, skal funksjonen returnere 1: fordi det er én gjest (Magica fra Tryll) som er sjekket inn når filen tar slutt.
- (10 poeng) Skriv en funksjon get_guests(table, time) hvor table er en liste på det formatet du valgte i første deloppgave, og time er en streng som representerer et tidspunkt på samme format som brukes i loggfilen. Funksjonen skal returnere en liste over hvilke gjester som er sjekket inn og hvilke rom de befinner seg på. Mer konkret: funksjonen skal returnere en liste av tupler, der hver tuple består av (navn, romnummer) for en person som er sjekket inn på det gitte tidspunktet.
Eksempel: dersom filen kun bestod av linjene i eksempelet over, og det angitte tidspunktet er '2024-01-02 10:50' skal funksjonen returnere listen [('Magica fra Tryll', '201'), ('Dolly', '302')].
import csv
from pathlib import Path

# Svaret på denne deloppgaven er basert på kursnotater om
# standardbiblioteket, avsnitt om CSV/DictReader
def load_file(path):
    with Path(path).open('rt', encoding='utf-8', newline='') as f:
        reader = csv.DictReader(f, delimiter=';')
        return list(reader)
def current_guest_count(table):
    count = 0
    for event in table:
        if event['hendelsestype'] == 'innsjekk':
            count += 1
        elif event['hendelsestype'] == 'utsjekk':
            count -= 1
    return count
def get_guests(table, time):
    currently_checked_in = {}
    for event in table:
        if event['tidspunkt'] > time:
            break
        elif event['hendelsestype'] == 'innsjekk':
            currently_checked_in[event['romnummer']] = event['navn på gjest']
        elif event['hendelsestype'] == 'utsjekk':
            currently_checked_in[event['romnummer']] = None

    result = []
    for room in currently_checked_in:
        if currently_checked_in[room] is not None:
            result.append((currently_checked_in[room], room))
    return result
def load_file(path):
    with open(path, 'r', encoding='utf-8') as f:
        content = f.read()
    lines = content.splitlines()
    table = []
    for line in lines:
        line = line.strip()
        row = line.split(';')
        table.append(row)
    return table
def current_guest_count(table):
    count = 0
    for event in table:
        if event[1] == 'innsjekk':
            count += 1
        elif event[1] == 'utsjekk':
            count -= 1
    return count
def get_guests(table, time):
    currently_checked_in = {}
    for event in table[1:]:
        if event[0] > time:
            break
        elif event[1] == 'innsjekk':
            currently_checked_in[event[2]] = event[3]
        elif event[1] == 'utsjekk':
            currently_checked_in[event[2]] = None

    result = []
    for room in currently_checked_in:
        if currently_checked_in[room] is not None:
            result.append((currently_checked_in[room], room))
    return result
Merk at sammenligningen av tidspunkt er mulig å gjøre som en streng-sammenligning uten å gå via datetime. Dette er mulig siden tidspunktene er formattert med mest signifikante enheter først, og med fast lengde på alle deler av tidspunktet.
load_file (5 poeng)
I deloppgaven om load_file finnes svaret mer eller mindre direkte i kursnotatene som var vedlagt eksamen. Koden må tilpasses til riktig seperator (semikolon) og variabel for filnavn.
- 1 poeng: åpner filen gitt av path og leser innholdet
- 1 poeng: deler opp linjene/radene på en eller annen måte (f. eks.
.splitlines(),.split('\n')eller konvertering til liste hvis bruk av csv-modulen for å lese filen,list(reader_object)) - 1 poeng: tar hensyn til at semikolon skiller kolonner (f. eks.
.split(';')på hver linje, eller bruk av navngitte parametre hvis bruk av csv-modulencsv.reader(f, delimiter=';')/csv.DictReader(f, delimiter=';')) - 1 poeng: returnerer en fornuftig sammensatt datastruktur
- 1 poeng: helhetsvurdering
Det trekkes ikke poeng for
- å ikke angi
encoding='utf-8'ved åpning av filen (tekstformat er ikke oppgitt). - å ikke angi
newline=''ved åpning av filen ved bruk av csv-modulen. Selv om dette egentlig alltid skal gjøres når man benytter csv-modulen, vil det fungere fint uten her. - å glemme å importere csv -modulen eller Path-klassen fra pathlib-modulen selv om disse brukes.
current_guest_count (9 poeng)
- 2 poeng: løkke over radene i tabellen
- 2 poeng: sjekker om hendelsestype er innsjekk eller utsjekk
- 2 poeng: book-keeping: en eller annen form for telling av antall gjester
- 3 poeng: helhetsvurdering
En mulig løsning vil være denne funksjonen:
def current_guest_count(table):
    return len(get_guests(table, '9999-12-31 23:59'))
En slik løsning kan gi full pott, men man må da vurdere get_guests-funksjonen i henhold til sensurkriteriene for denne deloppgaven.
get_guests (9 poeng)
- 2 poeng: fornuftig betingelse benyttet for å ignorere hendelser som skjer etter det gitte tidspunktet
- 2 poeng: sammenligner tidspunktet i raden med tidspunktet gitt som parameter på en fornuftig måte
- 3 poeng: book-keeping: en eller annen form for lagring av gjester som er sjekket inn på det gitte tidspunktet, typisk et oppslagsverk med romnummer som nøkkel og navn på gjest som verdi, samt korrekt oppdatering av dette i løkken.
- 1 poeng: koden håndterer at samme gjest sjekker inn og ut flere ganger
- 1 poeng: helhetsvurdering
Helhetsvurdering
Helhetsvurdering er basert på helhetlig korrekthet og forståelse av oppgaven.
- For besvarelser som i grove trekk er korrekte og får god uttelling på de øvrige kulepunktene, kan man gi litt trekk her for logiske feil (hvis noen) og dersom koden har dårlig struktur og/eller er spesielt vaskelig å lese.
- For besvarelser som får dårlig uttelling på de øvrige kulepunkt i forhold til hva besvarelsen demonstrerer av forståelse, kan sensor her gi en skjønnsmessig oppjustering. Dette gjelder for eksempel i tilfeller der det er skrevet kommentarer som viser intensjonen med en kodesnutt selv om gjennomføringen ikke var vellykket.
Om bruk av datetime-modulen
- Det er ikke nødvendig å benytte datetime eller andre kompliserte (hjelpe-)metoder for å sammenligne tidspunktene; det er fullt mulig å sammenligne tidspunktene direkte som strenger, siden de er formattert med mest signifikante enheter først og med fast lengde på alle deler av tidspunktet.
- Det vil ikke gi noe poengtrekk å bruke datetime-modulen for å sammenligne tidspunktene, selv om det er gjort små feil i konvertering fra streng til datetime.
- Det vil ikke gi poengtrekk å benytte en egen hjelpefunksjon for å sammenligne to tidspunkt. Små detaljfeil i implementasjonen av en slik hjelpefunksjon vil heller ikke gi poengtrekk.
- Å gjøre en innviklet/komplisert sammenligning av tidspunkter eller konvertering til datetime direkte i løkken uten å benytte en hjelpefunksjon vil gi trekk i helhetsvurderingen for dårlig struktur/lesbarhet.
Skriv en funksjon compress med en parameter text. Anta at text er en streng. La funksjonen returnere en liste av lister på formen [bokstav, antall], der hver indre liste beskriver en sammenhengende rekke av samme bokstav. For eksempel skal compress('aaafcc') returnere [['a',3],['f',1],['c',2]]. Funksjonen skal altså gjøre det motsatte av expand fra oppgave 1g. Hvis text er en tom streng, skal funksjonen returnere None.
def compress(text):
    if text == '':
        return None
    pairs = []
    for letter in text:
        if len(pairs) > 0 and pairs[-1][0] == letter:
            #same letter as before, increase count
            pairs[-1][1] += 1
        else:
            #new letter, create new pair
            pairs.append([letter, 1])
    return pairs
Poenfordeling
- (1 poeng) Går gjennom bokstavene i
textmed en løkke - (1,5 poeng) Ser om bokstaven er lik den forrige, og øker i så fall antallet
- (1 poeng) Starter en ny gruppe
[bokstav, 1]når bokstaven endrer seg, også for den første bokstaven - (1 poeng) Returnerer gruppene i riktig rekkefølge, inkludert den siste
- (0,5 poeng) Returnerer
Nonenår text er tom